Che cos'è il deep learning nel 2026 — le reti neurali profonde che hanno insegnato alle macchine a vedere, ascoltare, leggere e scrivere, e che stanno dietro all'AI generativa — che cosa può dare a un'azienda, in quali applicazioni è insostituibile, chi lo usa già e chi lo userà, quanto costa davvero, quando il machine learning classico è la scelta migliore, e come adottarlo senza costruire da zero ciò che si può prendere pronto
Ogni volta che un telefono riconosce un volto, un'app trascrive una nota vocale, un servizio traduce un testo in un attimo o un assistente come Claude o ChatGPT risponde a una domanda, al lavoro c'è il deep learning: reti neurali artificiali con molti strati, addestrate su grandi quantità di dati, capaci di imparare da sole a riconoscere schemi in immagini, suoni e testi. È la tecnica che negli ultimi quindici anni ha trasformato l'intelligenza artificiale da disciplina di laboratorio a tecnologia quotidiana, al punto che nel 2024 due premi Nobel — per la fisica e per la chimica — sono andati a ricerche sulle reti neurali e sulle loro applicazioni.
Questa guida percorre il deep learning per intero — che cos'è, caratteristiche principali, che cosa può dare e in quali applicazioni, chi lo usa già e chi lo userà, costi, strumenti, alternative e confronto, strategie di crescita e tendenze — con un obiettivo pratico: capire quando il deep learning serve davvero a un'azienda, e quando invece bastano strumenti più semplici. Completa la nostra guida completa al machine learning, di cui il deep learning è una parte, e rimanda alle guide tecniche sugli strumenti: PyTorch, TensorFlow, Keras e JAX.
Il dato da tenere a mente fin da subito viene dall'Istat: tra le imprese italiane che nel 2025 usano l'intelligenza artificiale, il 59,1% usa l'AI generativa, il 41,3% il riconoscimento vocale e circa il 18% il riconoscimento delle immagini — tutte tecnologie basate sul deep learning. In altre parole, la maggior parte delle aziende che adottano l'AI usa già il deep learning, quasi sempre senza costruirlo, attraverso servizi e modelli pronti. Tutti i dati sono stati verificati sulle fonti originali a ottobre 2026; dove un dato è di terzi lo diciamo.
INDICE DEI CONTENUTI
- Che cos'è il deep learning
- Le caratteristiche principali
- Che cosa può dare: i vantaggi competitivi
- Le applicazioni, settore per settore
- Chi lo usa già, e chi lo userà
- Costi
- Strumenti e integrazioni
- Alternative al deep learning e confronto
- Strategie di crescita usando il deep learning
- Tendenze future
-
Domande frequenti
- Che cos'è il deep learning, in parole semplici?
- Che differenza c'è tra deep learning e machine learning?
- Che cosa può fare il deep learning per un'azienda?
- Quali organizzazioni usano il deep learning?
- Il deep learning è adatto a una PMI?
- Quanto costa un progetto di deep learning?
- Servono GPU per fare deep learning?
- Quando conviene il machine learning classico invece del deep learning?
- In sintesi
Che cos'è il deep learning
Reti neurali con molti strati
Il deep learning è una famiglia di tecniche di machine learning basate sulle reti neurali artificiali: strutture matematiche composte da tanti piccoli elementi di calcolo, i neuroni artificiali, organizzati in strati. Ogni strato riceve i dati dallo strato precedente, li trasforma e li passa al successivo. «Profondo» (deep) indica proprio il numero di strati: decine, centinaia, nei modelli più grandi con miliardi di parametri da regolare.
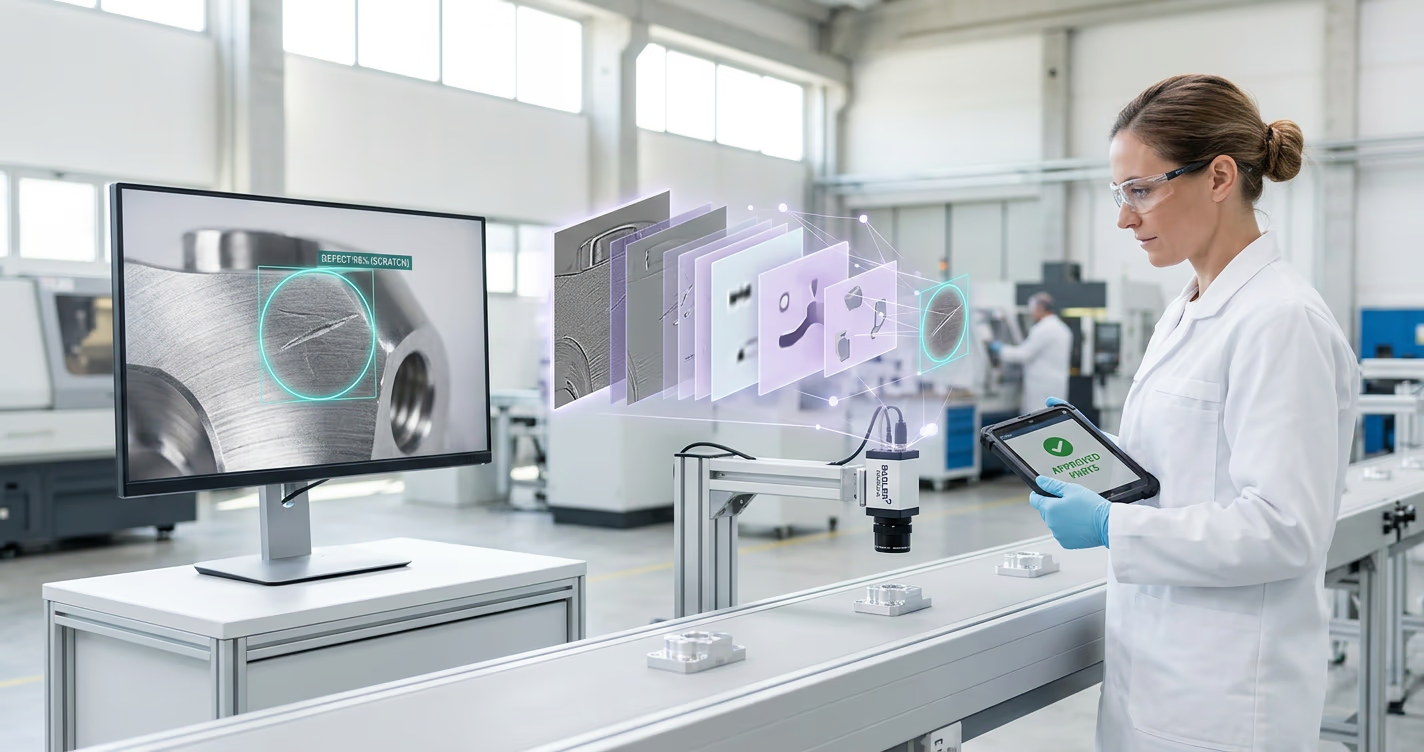
La caratteristica decisiva è che una rete profonda impara da sola le caratteristiche rilevanti dei dati. Nel machine learning classico, per riconoscere un difetto in un'immagine, un esperto doveva decidere quali misure estrarre — bordi, colori, forme. Una rete profonda riceve i pixel grezzi e impara, strato dopo strato, a riconoscere prima linee e contorni, poi forme, poi oggetti interi. È questa capacità di imparare rappresentazioni a renderla così efficace con dati complessi come immagini, suoni e linguaggio.
Deep learning, machine learning e AI generativa
Il deep learning è una parte del machine learning, che a sua volta è una parte dell'intelligenza artificiale. L'AI generativa — i grandi modelli linguistici e i generatori di immagini, audio e video — è a sua volta deep learning, addestrato su quantità enormi di dati per produrre contenuti nuovi. Non tutto il deep learning, però, è generativo: gran parte del suo uso nelle aziende è riconoscere — immagini, voce, documenti, segnali — e prevedere.
Le tappe che hanno cambiato tutto
Anno | Tappa | Perché conta |
|---|---|---|
2012 | AlexNet vince la competizione ImageNet | Una rete convoluzionale addestrata su GPU supera nettamente i metodi precedenti nel riconoscimento delle immagini: inizia l'era del deep learning |
2017 | L'architettura Transformer | Il meccanismo dell'attenzione rende possibile addestrare modelli linguistici molto più grandi e capaci |
2018 | Premio Turing a Bengio, Hinton e LeCun | Il riconoscimento più alto dell'informatica va ai pionieri del deep learning |
2020 | AlphaFold 2 | La previsione della struttura delle proteine raggiunge un'accuratezza paragonabile a quella sperimentale |
2022 | ChatGPT | L'AI generativa arriva al grande pubblico |
2024 | Due premi Nobel | Fisica a Hopfield e Hinton per le scoperte che rendono possibile l'apprendimento con le reti neurali; chimica a Baker, Hassabis e Jumper per il design e la previsione della struttura delle proteine |
2025 | Previsioni meteo operative con l'AI | Il Centro europeo per le previsioni meteorologiche a medio termine mette in produzione il suo modello basato sul machine learning |
Le architetture principali
Architettura | Per che cosa è adatta | Esempi di applicazione |
|---|---|---|
Reti convoluzionali (CNN) | Immagini e segnali con struttura spaziale | Controllo qualità visivo, diagnostica per immagini, lettura di documenti |
Reti ricorrenti (RNN, LSTM) | Sequenze nel tempo | Serie temporali, segnali dei sensori, in parte sostituite dai Transformer |
Transformer | Testo, ma anche immagini, audio e sequenze in generale | Modelli linguistici, traduzione, trascrizione, assistenti AI |
Modelli di diffusione | Generazione di immagini, video e audio | Creazione di contenuti visivi, design, prototipi |
Reti su grafi (GNN) | Dati in forma di rete e relazioni | Molecole, reti di trasporto, frodi tra entità collegate, previsioni meteo |
Autoencoder | Compressione e rilevamento di anomalie | Individuare comportamenti anomali in macchinari e transazioni |
Le caratteristiche principali
Il re dei dati non strutturati
Il deep learning dà il meglio con i dati non strutturati: immagini, video, audio, testi, documenti, segnali. Sono i dati che costituiscono la maggior parte delle informazioni di un'azienda — fotografie dei prodotti, scansioni di fatture e contratti, email, registrazioni delle chiamate, video delle linee produttive — e che il software tradizionale e il machine learning classico faticano a usare. È qui che il deep learning non ha rivali.
Cresce con dati e calcolo
Una proprietà fondamentale delle reti profonde è che, in generale, migliorano con più dati e più potenza di calcolo, molto più dei metodi classici. È la ragione della corsa a modelli sempre più grandi e ai processori specializzati — GPU e acceleratori dedicati — e anche la ragione per cui addestrare da zero un grande modello è alla portata di pochissime organizzazioni.
Modelli pre-addestrati: non serve partire da zero
Per un'azienda, la caratteristica più importante del deep learning moderno è il transfer learning: si parte da un modello già addestrato su enormi quantità di dati generali e lo si adatta al proprio problema con relativamente pochi esempi. Un modello di visione addestrato su milioni di immagini può imparare a riconoscere i difetti di un prodotto con qualche centinaio o migliaio di foto; un modello linguistico può essere adattato al linguaggio di un settore. Oppure lo si usa così com'è, tramite un servizio o un'API. È questo che rende il deep learning accessibile anche a una PMI.
Potente, ma meno trasparente
Il rovescio della medaglia è la spiegabilità. Una rete con milioni o miliardi di parametri non si legge come una regola: si può verificare se funziona, ma è difficile spiegare esattamente perché ha preso una certa decisione. Esistono tecniche per evidenziare quali parti di un'immagine o di un testo hanno influito sul risultato, ma in ambiti regolati — credito, sanità, selezione del personale — la minore trasparenza è un costo reale, da gestire con test, documentazione e supervisione umana.
Che cosa può dare: i vantaggi competitivi
Dare alle macchine vista, udito e lettura
Il primo vantaggio del deep learning è permettere ai sistemi informatici di vedere, ascoltare e leggere. Un impianto può controllare ogni pezzo prodotto con una telecamera; un servizio clienti può trascrivere e classificare ogni chiamata; un ufficio amministrativo può estrarre automaticamente i dati da migliaia di documenti. Sono attività che prima richiedevano persone dedicate e che ora possono essere svolte in modo continuo e su larga scala, lasciando alle persone i casi dubbi.
Produrre e trasformare contenuti
Con l'AI generativa, il deep learning permette di scrivere, riassumere, tradurre, generare immagini e voci. Per un'azienda significa bozze di documenti e offerte, schede prodotto, risposte ai clienti, traduzioni, materiali di marketing in tempi molto più brevi, a condizione di mantenere una revisione umana sui contenuti destinati all'esterno.
Prestazioni che i metodi classici non raggiungono
Su immagini, audio e linguaggio il deep learning ha superato nettamente i metodi precedenti, e in alcuni campi scientifici ha prodotto risultati senza precedenti. Il caso delle previsioni meteo è emblematico: il modello AIFS del Centro europeo per le previsioni meteorologiche a medio termine, entrato in produzione il 25 febbraio 2025, secondo l'ente supera i modelli fisici più avanzati su molte misure, con guadagni fino al 20% su alcune, come le traiettorie dei cicloni tropicali, usando circa mille volte meno energia per produrre una previsione.
Dove il vantaggio si rovescia
Una guida utile dice anche quando uno strumento è la scelta sbagliata. Il deep learning lo è in diversi casi.
Con i dati tabellari: su righe e colonne di un gestionale, i metodi classici come il gradient boosting sono spesso più precisi, più economici, più veloci e più spiegabili delle reti neurali.
Con pochi dati e nessun modello pre-addestrato adatto: le reti profonde hanno bisogno di molti esempi, a meno di partire da un modello esistente.
Quando serve spiegare ogni decisione: la minore trasparenza può essere un problema, anche normativo.
Quando il costo di calcolo non è giustificato: addestrare e servire grandi modelli richiede GPU ed energia; per problemi semplici è uno spreco.
Quando si vuole costruire da zero ciò che esiste già: per trascrizione, traduzione, lettura di documenti o assistenti testuali, quasi sempre conviene usare modelli pronti.
Le applicazioni, settore per settore
Dove il deep learning rende di più
Settore | Applicazioni tipiche | Tipo di dati |
|---|---|---|
Manifattura | Controllo qualità visivo, ispezione di saldature e superfici, robotica, manutenzione predittiva da vibrazioni e suoni | Immagini, video, segnali dei sensori |
Sanità | Supporto alla diagnosi su radiografie, TAC e risonanze, analisi di vetrini, trascrizione delle visite | Immagini cliniche, voce, testi |
Banche e assicurazioni | Lettura automatica di documenti e pratiche, stima dei danni da fotografie, assistenti per i clienti, antifrode su reti di transazioni | Documenti, immagini, testi, grafi |
Commercio ed e-commerce | Ricerca visiva dei prodotti, raccomandazioni, generazione di schede e immagini, assistenti alla vendita | Immagini, testi, comportamento degli utenti |
Servizi e pubblica amministrazione | Classificazione di richieste ed email, estrazione di dati da moduli, assistenti per i cittadini, trascrizione | Testi, documenti, voce |
Energia, ambiente e agricoltura | Previsioni meteo e di produzione rinnovabile, analisi di immagini satellitari e da drone, monitoraggio delle colture | Immagini, serie temporali, dati geospaziali |
Scienza e farmaceutica | Struttura delle proteine, scoperta di farmaci, nuovi materiali | Sequenze, molecole, dati sperimentali |
Le applicazioni più adatte a una PMI
Per una piccola o media impresa, il deep learning arriva quasi sempre attraverso modelli pronti: trascrizione e sintesi delle chiamate, estrazione di dati da fatture e documenti, classificazione delle email, assistenti per il servizio clienti, generazione di testi e immagini per il marketing. Il progetto su misura più frequente e più redditizio è il controllo qualità visivo nelle aziende manifatturiere: un modello di visione pre-addestrato, adattato con le fotografie dei propri prodotti, che segnala i pezzi difettosi su una linea esistente.
Chi lo usa già, e chi lo userà
Casi documentati, solo con fonti ufficiali
Centro europeo per le previsioni meteorologiche a medio termine (ECMWF): dal 25 febbraio 2025 il modello AIFS è operativo accanto a quello fisico tradizionale, con prestazioni migliori su molte misure e un consumo energetico per previsione circa mille volte inferiore, secondo l'ente.
Google DeepMind e AlphaFold: il sistema che prevede la struttura delle proteine ha valso a Demis Hassabis e John Jumper il premio Nobel per la chimica 2024, condiviso con David Baker. Nello stesso anno il Nobel per la fisica è andato a John Hopfield e Geoffrey Hinton per le scoperte che hanno reso possibile l'apprendimento con le reti neurali.
Google DeepMind e i data center: un sistema di reti neurali profonde addestrato sui dati di migliaia di sensori ha ridotto fino al 40% l'energia per il raffreddamento dei data center di Google, secondo quanto documentato dall'azienda nel 2016.
Dispositivi medici: l'agenzia statunitense FDA mantiene un elenco pubblico dei dispositivi medici basati sull'intelligenza artificiale autorizzati; secondo i conteggi di terzi basati su quell'elenco ha superato i 1.400 dispositivi, in grande maggioranza nel campo della radiologia, dove il deep learning applicato alle immagini è la tecnologia prevalente.
I modelli linguistici italiani: la famiglia Minerva, sviluppata dal gruppo di Roberto Navigli alla Sapienza con la Fondazione FAIR e addestrata sul supercomputer Leonardo del Cineca, è indicata come il primo modello linguistico addestrato da zero in italiano; Domyn (già iGenius) ha sviluppato Italia-10B e Colosseum-355B per settori regolati, e Almawave il modello Velvet, pensato per la pubblica amministrazione e i contact center.
In Italia: tanto uso indiretto, poco sviluppo proprio
I dati Istat del 2025 mostrano che, tra le imprese italiane che usano l'intelligenza artificiale — il 16,4% di quelle con almeno 10 addetti —, le tecnologie più diffuse sono l'analisi dei testi (70,8%), l'AI generativa (59,1%) e il riconoscimento vocale (41,3%): quasi tutte basate sul deep learning. Ma l'uso è soprattutto indiretto, tramite servizi e licenze: secondo l'Osservatorio del Politecnico di Milano, l'84% delle grandi imprese ha acquistato licenze di AI generativa, mentre i progetti costruiti su misura sono molti meno. Il divario tra grandi imprese (53,1% di adozione) e PMI (15,7%) resta ampio.
Chi lo userà nei prossimi anni
La prossima ondata riguarderà soprattutto tre gruppi. Le imprese manifatturiere che hanno già telecamere e sensori sulle linee e possono aggiungere controllo qualità e manutenzione basati sulla visione e sull'analisi dei segnali. Le aziende con molti documenti e molte interazioni — assicurazioni, banche, studi professionali, pubblica amministrazione, servizi — che possono automatizzare lettura, classificazione e risposte. E le aziende che adattano modelli pre-addestrati ai propri dati, anche in versioni piccole da far girare sui propri server per ragioni di riservatezza. Per tutti, gli ostacoli principali restano quelli indicati dall'Istat: competenze, dati, chiarezza delle regole.
Costi
Tre strade, tre ordini di costo
Per un'azienda il costo del deep learning dipende soprattutto da quale strada si sceglie, e le strade sono tre.
Strada | Che cosa significa | Costi principali | Quando conviene |
|---|---|---|---|
Usare modelli pronti | Servizi e API per trascrizione, visione, lettura di documenti, modelli linguistici | Canone o costo per uso, lavoro di integrazione | Per la maggior parte delle esigenze comuni; è il punto di partenza consigliato |
Adattare un modello pre-addestrato | Fine-tuning o adattamento di un modello esistente con i propri dati | Raccolta ed etichettatura dei dati, competenze, GPU per l'addestramento e per l'uso | Problemi specifici dell'azienda, come il controllo qualità o un linguaggio di settore |
Addestrare da zero | Progettare e addestrare un modello nuovo | Grandi quantità di dati, infrastruttura di calcolo importante, team specializzato | Raramente; solo per problemi unici o per chi fa del modello il proprio prodotto |
Il calcolo: GPU, cloud e uso
Il deep learning ha bisogno di processori specializzati, soprattutto GPU, sia per addestrare i modelli sia, nei modelli grandi, per usarli. Si possono noleggiare nel cloud a ore, oppure acquistare per tenerle in azienda quando i dati non possono uscire o l'uso è continuo. Un punto spesso sottovalutato: per molti progetti il costo maggiore nel tempo non è l'addestramento, ma l'inferenza, cioè l'uso quotidiano del modello. Scegliere un modello della dimensione giusta, non il più grande disponibile, è la prima forma di risparmio.
Il costo vero: dati etichettati e persone
Come per il machine learning classico, la voce più alta resta il lavoro delle persone: definire il problema, raccogliere ed etichettare i dati — per esempio fotografare e classificare centinaia di pezzi buoni e difettosi —, addestrare, valutare, integrare e mantenere il modello. Un progetto di deep learning su misura richiede competenze più rare di uno di machine learning classico, e questo si riflette sul costo.
Strumenti e integrazioni
I framework
Il deep learning si sviluppa quasi sempre in Python, con pochi framework principali. PyTorch è lo standard di fatto nella ricerca e sempre più nell'industria; TensorFlow e Keras sono diffusi in molti sistemi in produzione, e Keras 3 funziona sopra diversi motori; JAX è la scelta per il calcolo scientifico e l'addestramento su larga scala. Li abbiamo approfonditi uno per uno: PyTorch, TensorFlow, Keras, JAX.
Archivi di modelli pre-addestrati
Una parte essenziale dell'ecosistema sono gli archivi di modelli pre-addestrati, come Hugging Face, dove si trova un numero enorme di modelli aperti per visione, linguaggio, audio e altri compiti, molti con licenze che ne permettono l'uso commerciale. Per un'azienda sono il punto di partenza naturale: si sceglie un modello adatto, lo si prova sui propri dati e, se serve, lo si adatta. Va sempre verificata la licenza, e con essa i limiti all'uso commerciale.
Portare un modello in produzione
Un modello addestrato va servito agli altri sistemi, di solito come servizio con un'API, e monitorato. Per l'uso su dispositivi o server meno potenti si usano tecniche di ottimizzazione — modelli più piccoli, precisione ridotta, formati di scambio come ONNX — che riducono costi e tempi di risposta. Come per ogni progetto di machine learning, servono tracciabilità, monitoraggio della qualità nel tempo e un responsabile.
Integrare il deep learning nei processi
Il valore nasce quando il risultato del modello arriva dove si lavora: l'allarme sul pezzo difettoso sul pannello della linea, i dati estratti dalla fattura nel gestionale, la trascrizione della chiamata nella scheda del cliente. Per questo i progetti di deep learning sono quasi sempre anche progetti di sviluppo e integrazione software, in qualunque linguaggio sia scritto il sistema aziendale.
Alternative al deep learning e confronto
Il confronto in una tabella
Approccio | Dove eccelle | Quando preferirlo al deep learning | Il limite |
|---|---|---|---|
Machine learning classico (gradient boosting, modelli lineari) | Dati tabellari: vendite, clienti, rischio, ordini | Quasi sempre con dati strutturati, pochi dati, necessità di spiegare | Debole con immagini, audio e testi |
Regole e software tradizionale | Processi chiari e stabili | Quando le regole si scrivono e reggono nel tempo | Non riconosce schemi complessi |
Visione artificiale tradizionale | Misure precise in condizioni controllate | Ispezioni semplici con illuminazione e posizione costanti | Fragile a variazioni e difetti non previsti |
Statistica e modelli fisici | Fenomeni ben descritti da equazioni | Quando la conoscenza del fenomeno è solida e i dati sono pochi | Costosi da sviluppare, meno flessibili |
Deep learning su misura | Immagini, audio, testi, segnali, problemi specifici | Quando nessun modello pronto basta e ci sono dati | Dati etichettati, calcolo, competenze |
Modelli pronti e API | Trascrizione, traduzione, lettura di documenti, assistenti | Per le esigenze comuni, come primo passo | Costo per uso, dipendenza dal fornitore, dati che escono dall'azienda |
Deep learning contro machine learning classico: la domanda vera
La domanda giusta non è quale tecnica sia migliore, ma che tipo di dati si hanno. Con immagini, audio, video e testi, il deep learning è quasi sempre la scelta vincente. Con dati tabellari — le righe e colonne di gestionali, CRM e fogli di calcolo — i metodi classici come il gradient boosting restano spesso più precisi e molto più economici, ed è la ragione per cui gran parte dei progetti aziendali di previsione non usa reti neurali. Ne parliamo nella guida al machine learning e nella guida a scikit-learn. Sempre più spesso, poi, le due cose si combinano: una rete legge un documento o un'immagine e ne estrae i dati, un modello classico li usa per stimare un rischio o una priorità.
Costruire o usare un modello pronto
Per la maggior parte delle aziende la vera scelta non è tra deep learning e altre tecniche, ma tra costruire e usare. I modelli pronti, tramite servizi o modelli aperti, coprono ormai la maggior parte delle esigenze comuni con costi e tempi molto inferiori. Costruire o adattare ha senso quando il problema è specifico dell'azienda, quando i dati non possono uscire, o quando il modello è parte del valore che si vende.
Come si decide: cinque domande
Che tipo di dati ho? Immagini, audio, testi: deep learning. Tabelle: machine learning classico.
Esiste già un modello o un servizio che fa questo? Sì: si parte da lì.
Quanti esempi etichettati posso raccogliere? Pochi: modello pre-addestrato e adattamento. Nessuno: prima si raccolgono i dati.
I dati possono uscire dall'azienda? No: modelli aperti eseguiti sui propri server.
Devo spiegare ogni decisione? Sì: valutare con attenzione, e prevedere supervisione umana.
Strategie di crescita usando il deep learning
Un percorso di adozione che funziona
Mappare i dati non strutturati: documenti, immagini, registrazioni, email; dove si accumulano e chi li elabora a mano.
Partire da modelli pronti: trascrizione, lettura di documenti, classificazione dei testi; risultati in poche settimane.
Scegliere un caso su misura con un indicatore economico chiaro, come scarti o tempo di lavorazione.
Raccogliere ed etichettare i dati, partendo da un modello pre-addestrato per ridurne la quantità necessaria.
Prototipo e confronto con il processo attuale, poi messa in produzione con supervisione umana sui casi dubbi.
Monitorare e allargare, riutilizzando dati, competenze e infrastruttura.
Qualità e scarti nella manifattura
Per le imprese manifatturiere italiane, il controllo qualità visivo è l'applicazione con il ritorno più diretto: meno scarti, meno resi, ispezione del cento per cento dei pezzi invece che a campione, dati sui difetti che aiutano a correggere il processo a monte. Il punto di partenza è spesso più semplice del previsto: telecamere già presenti, un archivio di immagini da etichettare, un modello pre-addestrato da adattare.
Documenti e conversazioni: liberare tempo
Nei servizi, il deep learning applicato a documenti e conversazioni è il modo più rapido per liberare tempo: estrazione dei dati da fatture, contratti e pratiche, classificazione e instradamento delle email, trascrizione e sintesi delle chiamate, bozze di risposta. Il valore si misura in ore risparmiate e in tempi di risposta ai clienti, e si ottiene spesso con modelli pronti e un buon lavoro di integrazione.
Competenze e affiancamento
Le competenze di deep learning sono rare e richieste: secondo l'Osservatorio del Politecnico di Milano, nel 2025 circa 44.000 annunci di lavoro in Italia chiedevano competenze di intelligenza artificiale, con una crescita del 93%. Per la maggior parte delle aziende la strada più rapida è affiancarsi a professionisti esterni per i primi progetti, trasferendo competenze al team interno. Vedi anche le nostre guide al freelance Python per l'intelligenza artificiale e sul mercato dei freelance AI in Italia.
Regole: AI Act e GDPR
Il deep learning tocca spesso dati personali — volti, voci, documenti — e il GDPR si applica pienamente, con particolare attenzione ai dati biometrici e sanitari. L'AI Act europeo prevede obblighi specifici per i fornitori di modelli di AI per finalità generali dall'agosto 2025, obblighi di trasparenza per i contenuti generati e, per gli usi ad alto rischio come quelli in sanità, lavoro o credito, requisiti di gestione del rischio, qualità dei dati e supervisione umana, la cui applicazione per i sistemi autonomi è stata rinviata al 2 dicembre 2027. Chi usa modelli di terzi deve sapere da dove vengono e come sono stati addestrati.
Che cosa misurare
Gli indicatori tecnici — precisione, falsi positivi e falsi negativi, tempi di risposta — servono a capire se il modello funziona; quelli di business servono a capire se vale la pena: scarti ridotti, ore risparmiate, documenti elaborati senza intervento umano, tempi di risposta ai clienti, costo di calcolo per operazione. Un modello eccellente che costa più del lavoro che sostituisce non è un successo.
Tendenze future
Modelli multimodali e di fondazione
La tendenza più evidente è la diffusione di modelli di fondazione multimodali, capaci di lavorare insieme su testo, immagini, audio e video. Per le aziende significa meno modelli specializzati da costruire e più modelli generali da adattare: lo stesso sistema che legge un documento può guardare una fotografia del danno e ascoltare la telefonata del cliente.
Modelli più piccoli, più efficienti, più vicini
Accanto ai modelli giganti cresce una famiglia di modelli piccoli ed efficienti, che girano su un server aziendale, su un computer o direttamente su telecamere, macchinari e smartphone. Riducono costi, consumi e tempi di risposta e permettono di tenere i dati in casa: per molte aziende europee, attente alla riservatezza, saranno la scelta più adatta.
Il deep learning per la scienza e l'industria
Dalle proteine alle previsioni meteo, dai materiali ai farmaci, il deep learning sta diventando uno strumento scientifico di primo piano, come mostrano i Nobel del 2024 e l'adozione operativa da parte di enti come l'ECMWF. Nei prossimi anni questi metodi arriveranno sempre più spesso nella progettazione industriale, nella simulazione e nella ricerca applicata delle aziende.
Dagli strumenti agli agenti
I grandi modelli basati sul deep learning stanno diventando il «cervello» degli agenti AI, sistemi che pianificano ed eseguono compiti usando altri strumenti, compresi modelli di machine learning classico e software aziendale. Il deep learning passa così dall'essere una funzione dentro un'applicazione all'essere il motore che coordina il lavoro tra applicazioni diverse.
Energia e sovranità
La crescita dei modelli porta con sé due questioni destinate a pesare: il consumo di energia dei data center e la sovranità tecnologica, cioè la capacità di un paese o di un'azienda di non dipendere interamente da modelli e infrastrutture altrui. I modelli italiani ed europei, i supercomputer pubblici come Leonardo e i modelli aperti eseguibili in proprio sono risposte, ancora parziali, a entrambe.
Che cosa non cambierà
Qualunque architettura prevalga, tre cose restano ferme. Servono dati di qualità, e nel deep learning anche etichettati bene. Serve scegliere lo strumento giusto: non tutto richiede una rete neurale. Serve una persona responsabile che verifichi i risultati, soprattutto quando il modello decide su persone, salute o denaro.
Domande frequenti
Che cos'è il deep learning, in parole semplici?
È una famiglia di tecniche di machine learning basate su reti neurali artificiali con molti strati, che imparano da grandi quantità di esempi a riconoscere schemi complessi. A differenza dei metodi classici, una rete profonda impara da sola quali caratteristiche dei dati sono importanti, ed è per questo che funziona così bene con immagini, suoni, testi e video. È la tecnologia alla base del riconoscimento vocale, della visione artificiale e dell'AI generativa.
Che differenza c'è tra deep learning e machine learning?
Il deep learning è una parte del machine learning. Il machine learning classico funziona molto bene con dati tabellari, come vendite o anagrafiche, e spesso richiede che un esperto scelga le caratteristiche da usare. Il deep learning usa reti neurali profonde che imparano da sole le caratteristiche, ed eccelle con dati non strutturati come immagini, audio e testo, ma richiede più dati, più calcolo ed è meno trasparente.
Che cosa può fare il deep learning per un'azienda?
Può controllare la qualità dei prodotti con le telecamere, leggere ed estrarre dati da fatture, contratti e pratiche, trascrivere e riassumere chiamate, classificare email e richieste, supportare la diagnosi su immagini mediche, generare e tradurre testi e immagini, prevedere guasti da vibrazioni e suoni, analizzare immagini satellitari e da drone. In generale, dà ai sistemi informatici la capacità di vedere, ascoltare e leggere.
Quali organizzazioni usano il deep learning?
Lo usano le grandi piattaforme digitali per riconoscimento, raccomandazioni e assistenti; il Centro europeo per le previsioni meteorologiche a medio termine per le previsioni operative dal 2025; la ricerca scientifica, con AlphaFold premiato con il Nobel per la chimica 2024; la sanità, con oltre 1.400 dispositivi medici basati sull'AI autorizzati negli Stati Uniti secondo conteggi di terzi, soprattutto in radiologia. In Italia, oltre alle imprese che usano servizi di AI generativa e riconoscimento vocale, ci sono modelli linguistici italiani come Minerva, Italia e Velvet.
Il deep learning è adatto a una PMI?
Sì, soprattutto attraverso modelli pronti: trascrizione, lettura di documenti, classificazione di testi, assistenti, generazione di contenuti. Il progetto su misura più adatto alle PMI manifatturiere è il controllo qualità visivo, partendo da un modello pre-addestrato adattato con le fotografie dei propri prodotti. Addestrare grandi modelli da zero, invece, non è quasi mai necessario né conveniente.
Quanto costa un progetto di deep learning?
Dipende dalla strada scelta. Usare modelli pronti costa un canone o un prezzo per uso più il lavoro di integrazione; adattare un modello pre-addestrato richiede dati etichettati, competenze specialistiche e GPU per addestramento e uso; addestrare da zero richiede grandi quantità di dati e infrastrutture importanti. Nel tempo, spesso, il costo maggiore è l'uso quotidiano del modello, per questo conviene scegliere un modello della dimensione giusta.
Servono GPU per fare deep learning?
Per addestrare reti profonde in tempi ragionevoli sì, servono GPU o acceleratori specializzati, che si possono noleggiare nel cloud a ore o acquistare. Per usare un modello già addestrato dipende dalle dimensioni: i modelli piccoli e ottimizzati possono girare anche su normali server, computer o dispositivi, mentre i grandi modelli linguistici richiedono hardware dedicato o servizi esterni.
Quando conviene il machine learning classico invece del deep learning?
Quando i dati sono tabellari — righe e colonne di gestionali, CRM, fogli di calcolo — i metodi classici come il gradient boosting sono spesso più precisi, più economici, più veloci e più facili da spiegare delle reti neurali. Conviene anche quando i dati sono pochi e non esiste un modello pre-addestrato adatto, o quando ogni decisione deve essere spiegata. Il deep learning è la scelta giusta con immagini, audio, testi e segnali complessi.
In sintesi
Il deep learning, nel 2026, è la tecnologia che ha dato alle macchine vista, udito e linguaggio, e che sta dietro all'AI generativa, ai progressi nelle previsioni meteo e alle scoperte scientifiche premiate con due Nobel. Per un'azienda il suo valore sta soprattutto nei dati non strutturati — immagini, documenti, voce, testi — e quasi sempre si ottiene usando o adattando modelli pronti, non costruendoli da zero. Con i dati tabellari, invece, il machine learning classico resta spesso la scelta migliore.
Le tre cose da portare via, se ne resta spazio solo per tre. Primo: scegliete la tecnica in base ai dati — immagini, audio e testi chiedono deep learning, le tabelle no. Secondo: partite da ciò che esiste già — modelli pronti e pre-addestrati coprono la maggior parte delle esigenze, e adattarli costa molto meno che costruirli. Terzo: il costo vero è nei dati e nell'uso quotidiano — dati etichettati bene, modelli della dimensione giusta e una persona responsabile valgono più dell'architettura più recente.
Se vuoi capire dove il deep learning può creare valore nella tua azienda, avviare un progetto di visione artificiale o di elaborazione dei documenti, adattare un modello ai tuoi dati o integrare servizi di AI nei tuoi sistemi, su FreelanceWWW trovi data scientist, ingegneri del machine learning e sviluppatori che lavorano con PyTorch, TensorFlow, Keras, JAX e i modelli di oggi: pubblica il tuo progetto e ricevi le offerte dai freelance che quel lavoro lo hanno già fatto. Per approfondire, leggi la guida completa al machine learning e le guide a PyTorch, TensorFlow, Keras e JAX.